Business Problem → Data → Cleaning → Analysis → Visualization → Findings → Recommendation
Project Overview
Cyclistic is a bike-share company seeking to increase annual memberships by converting casual riders into annual members.
As a Junior Data Analyst, I analyzed bike-share trip data to identify differences in trip frequency, duration, bike preference, time of use, day-of-week patterns, and station usage between annual members and casual riders.
The analysis was designed to answer:
How do annual members and casual riders use Cyclistic bikes differently, and how can those differences inform a membership marketing strategy?
Ask
Business Objective
Increase annual memberships by identifying behavioral patterns among casual riders that can inform targeted membership marketing.
Business Question
How do annual members and casual riders use Cyclistic bikes differently?
Stakeholders
- Lily Moreno — Director of Marketing: responsible for marketing campaigns and membership initiatives.
- Cyclistic Marketing Analytics Team: responsible for analyzing customer behavior and reporting insights.
- Cyclistic Executive Team: responsible for evaluating and approving the proposed marketing strategy.
Prepare
Data Source
The analysis used Cyclistic/Divvy trip data provided by Motivate International Inc.
The dataset contained approximately 559,000 trips and 13 fields, including:
- Ride ID
- Bike type
- Start/end timestamps
- Start/end stations
- Geographic coordinates
- Rider type
Data Quality
I evaluated the dataset for:
- Missing values
- Duplicate records
- Incorrect data types
- Invalid trip durations
- Missing station information
- Inconsistent categorical variables
After cleaning and filtering, approximately 545,000 trips remained for analysis.
Process
I used RStudio and the following packages:
library(tidyverse)library(lubridate)library(scales)library(skimr)library(knitr)Data Cleaning Workflow
Raw CSV
↓
Import into R
↓
Check structure and missing values
↓
Remove incomplete records
↓
Remove duplicates
↓
Convert data types
↓
Create analytical variables
↓
Validate trip duration
↓
Create analysis datasets
↓
Analyze and visualize
The analysis created additional variables including:
- Hour of day
- Day of week
- Month
- Day of month
- Week number
- Trip duration
# install.packages(c("tidyverse", "lubridate", "scales", "skimr", "knitr"))library(tidyverse)library(lubridate)library(scales)library(skimr)library(knitr)# Set working directory if necessarygetwd()# Import datamy_data <- read_csv("202210-divvy-tripdata.csv")# Inspect dataglimpse(my_data)# Number of rows and columnsdim(my_data)# Summary statisticssummary(my_data)# Check missing valuescolSums(is.na(my_data))# Check duplicate rowssum(duplicated(my_data))# Check unique rider typesunique(my_data$member_casual)# Check bike typesunique(my_data$rideable_type)trip_clean <- my_data %>%# Remove rows with missing valuesdrop_na() %>%# Remove duplicate recordsdistinct() %>%# Rename columnsrename(bike_type = rideable_type,rider_type = member_casual) %>%# Convert variablesmutate(bike_type = as.factor(bike_type),rider_type = as.factor(rider_type),started_at = ymd_hms(started_at),ended_at = ymd_hms(ended_at))trip_clean <- trip_clean %>%mutate(# Trip duration in minutestrip_duration = as.numeric(difftime(ended_at, started_at, units = "mins")),# Hour of trip startstart_hour = hour(started_at),# Day of weekday_of_week = wday(started_at,label = TRUE,abbr = FALSE,week_start = 1),# Monthmonth = month(started_at,label = TRUE,abbr = FALSE),# Day of monthday = day(started_at),# Week numberweek = isoweek(started_at))trip_clean <- trip_clean %>%filter(trip_duration >= 1,trip_duration <= 1440)nrow(trip_clean)# Missing valuescolSums(is.na(trip_clean))# Duplicate rowssum(duplicated(trip_clean))# Trip duration summarysummary(trip_clean$trip_duration)# Rider countstable(trip_clean$rider_type)# Bike countstable(trip_clean$bike_type)rider_summary <- trip_clean %>%group_by(rider_type) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),median_trip_duration = median(trip_duration),total_trip_duration = sum(trip_duration),.groups = "drop") %>%mutate(percentage_of_trips =number_of_trips / sum(number_of_trips) * 100)rider_summaryrider_summary <- trip_clean %>%group_by(rider_type) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),median_trip_duration = median(trip_duration),total_trip_duration = sum(trip_duration),.groups = "drop") %>%mutate(percentage_of_trips =number_of_trips / sum(number_of_trips) * 100)rider_summaryggplot(rider_summary,aes(x = rider_type,y = average_trip_duration,fill = rider_type)) +geom_col(show.legend = FALSE) +labs(title = "Average Trip Duration by Rider Type",x = "Rider Type",y = "Average Trip Duration (Minutes)") +theme_minimal()hour_summary <- trip_clean %>%group_by(rider_type, start_hour) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),.groups = "drop")ggplot(hour_summary,aes(x = start_hour,y = number_of_trips,fill = rider_type)) +geom_col(position = "dodge") +scale_y_continuous(labels = comma) +scale_x_continuous(breaks = 0:23) +labs(title = "Trips by Hour of Day",x = "Hour of Day",y = "Number of Trips",fill = "Rider Type") +theme_minimal()day_summary <- trip_clean %>%group_by(rider_type, day_of_week) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),.groups = "drop")ggplot(day_summary,aes(x = day_of_week,y = number_of_trips,fill = rider_type)) +geom_col(position = "dodge") +scale_y_continuous(labels = comma) +labs(title = "Trips by Day of Week",x = "Day of Week",y = "Number of Trips",fill = "Rider Type") +theme_minimal()ggplot(day_summary,aes(x = day_of_week,y = average_trip_duration,fill = rider_type)) +geom_col(position = "dodge") +labs(title = "Average Trip Duration by Day of Week",x = "Day of Week",y = "Average Trip Duration (Minutes)",fill = "Rider Type") +theme_minimal()bike_summary <- trip_clean %>%group_by(rider_type, bike_type) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),total_trip_duration = sum(trip_duration),.groups = "drop")bike_summaryggplot(bike_summary,aes(x = bike_type,y = number_of_trips,fill = rider_type)) +geom_col(position = "dodge") +scale_y_continuous(labels = comma) +labs(title = "Bike Type Usage by Rider Type",x = "Bike Type",y = "Number of Trips",fill = "Rider Type") +theme_minimal()ggplot(bike_summary,aes(x = bike_type,y = average_trip_duration,fill = rider_type)) +geom_col(position = "dodge") +labs(title = "Average Trip Duration by Bike Type",x = "Bike Type",y = "Average Trip Duration (Minutes)",fill = "Rider Type") +theme_minimal()start_station_summary <- trip_clean %>%filter(!is.na(start_station_name)) %>%group_by(rider_type,start_station_name) %>%summarise(number_of_trips = n(),.groups = "drop") %>%arrange(rider_type,desc(number_of_trips))top_10_start_stations <- start_station_summary %>%group_by(rider_type) %>%slice_max(order_by = number_of_trips,n = 10) %>%ungroup()top_10_start_stationstop_casual_start_stations <- start_station_summary %>%filter(rider_type == "casual") %>%slice_max(order_by = number_of_trips,n = 10)top_casual_start_stationsggplot(top_casual_start_stations,aes(x = reorder(start_station_name, number_of_trips),y = number_of_trips)) +geom_col() +coord_flip() +scale_y_continuous(labels = comma) +labs(title = "Top 10 Starting Stations Used by Casual Riders",x = "Starting Station",y = "Number of Trips") +theme_minimal()end_station_summary <- trip_clean %>%filter(!is.na(end_station_name)) %>%group_by(rider_type,end_station_name) %>%summarise(number_of_trips = n(),.groups = "drop") %>%arrange(rider_type,desc(number_of_trips))top_casual_end_stations <- end_station_summary %>%filter(rider_type == "casual") %>%slice_max(order_by = number_of_trips,n = 10)top_casual_end_stationstrip_clean <- trip_clean %>%mutate(day_type = if_else(day_of_week %in% c("Saturday", "Sunday"),"Weekend","Weekday"))day_type_summary <- trip_clean %>%group_by(rider_type, day_type) %>%summarise(number_of_trips = n(),average_trip_duration = mean(trip_duration),.groups = "drop")day_type_summaryggplot(day_type_summary,aes(x = day_type,y = number_of_trips,fill = rider_type)) +geom_col(position = "dodge") +scale_y_continuous(labels = comma) +labs(title = "Weekday vs Weekend Usage",x = "Day Type",y = "Number of Trips",fill = "Rider Type") +theme_minimal()ggplot(trip_clean,aes(x = trip_duration,fill = rider_type)) +geom_histogram(bins = 50,alpha = 0.6,position = "identity") +coord_cartesian(xlim = c(0, 120)) +labs(title = "Trip Duration Distribution",x = "Trip Duration (Minutes)",y = "Number of Trips",fill = "Rider Type") +theme_minimal()final_summary <- trip_clean %>%group_by(rider_type) %>%summarise(total_trips = n(),average_duration = mean(trip_duration),median_duration = median(trip_duration),maximum_duration = max(trip_duration),weekday_trips = sum(day_type == "Weekday"),weekend_trips = sum(day_type == "Weekend"),.groups = "drop") %>%mutate(percentage_of_trips =total_trips / sum(total_trips) * 100)final_summarywrite_csv(trip_clean,"cyclistic_cleaned_data.csv")write_csv(rider_summary,"rider_summary.csv")write_csv(hour_summary,"hour_summary.csv")write_csv(day_summary,"day_summary.csv")write_csv(bike_summary,"bike_summary.csv")write_csv(top_casual_start_stations,"top_casual_start_stations.csv")write_csv(top_casual_end_stations,"top_casual_end_stations.csv")write_csv(final_summary,"cyclistic_final_summary.csv")Analyze
Question 1 — How frequently do members and casual riders ride?
Compare:
Number of trips
Member vs. Casual
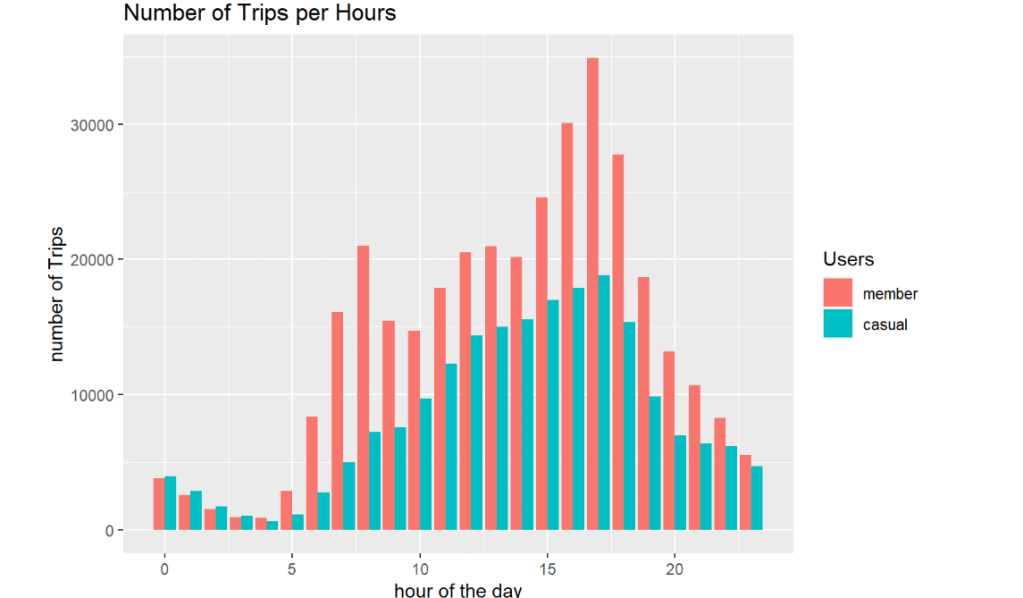
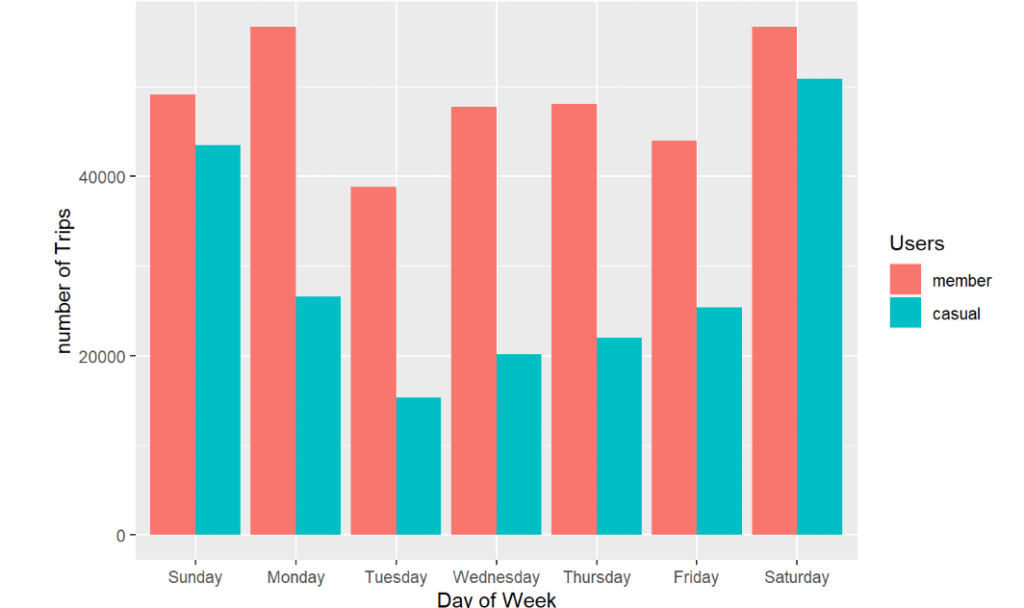
Question 2 — When do they ride?
Analyze:
- Hour
- Day of week
- Month
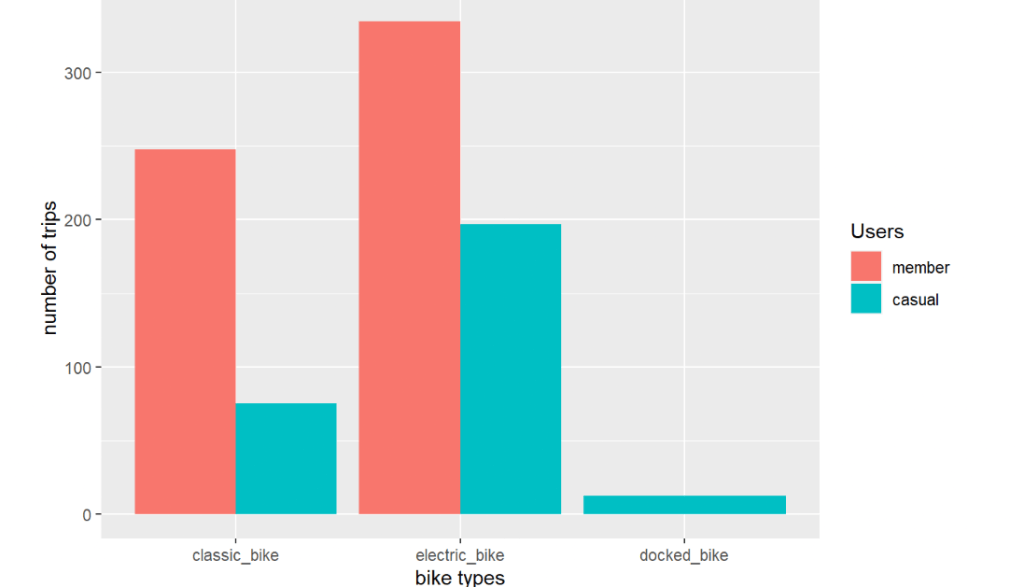
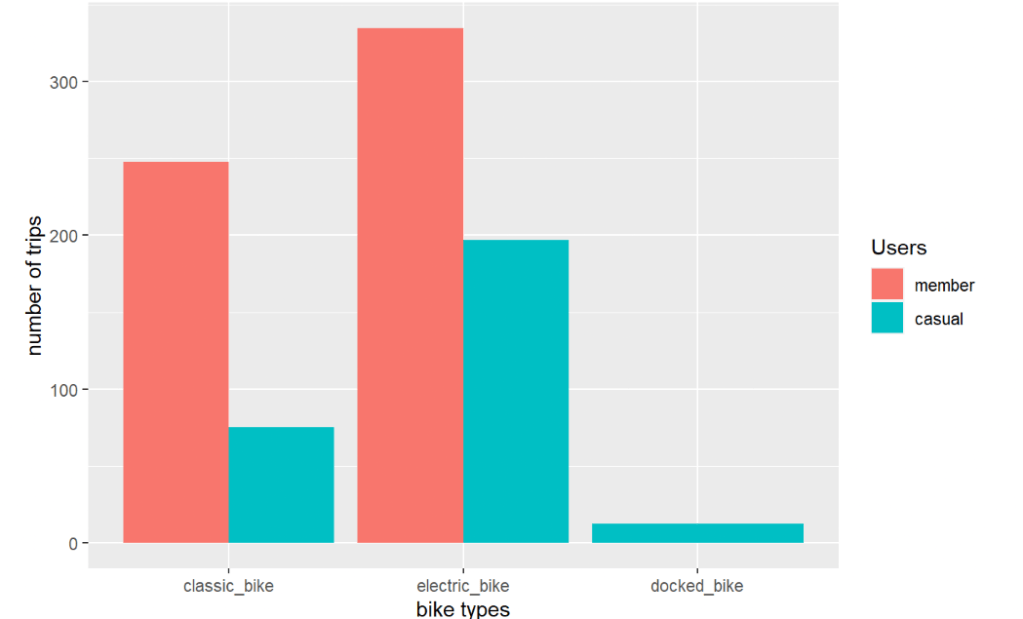
Question 3 – Which bikes do they use?
Compare:
- Classic bike
- Electric bike
- Docked bike
Question 4 – Where do they ride?
Identify:
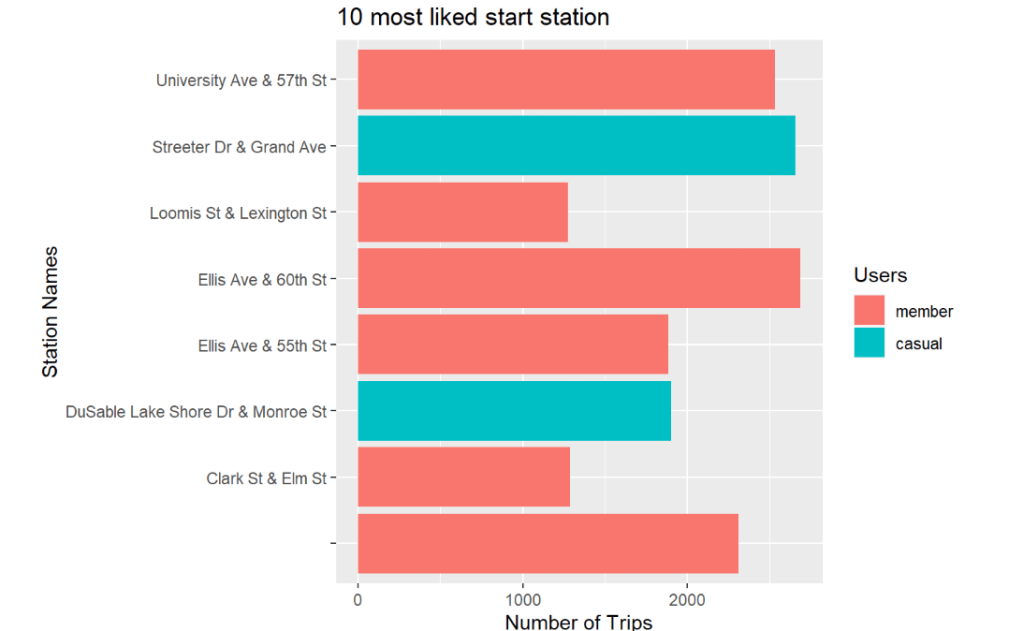
- Most popular starting stations
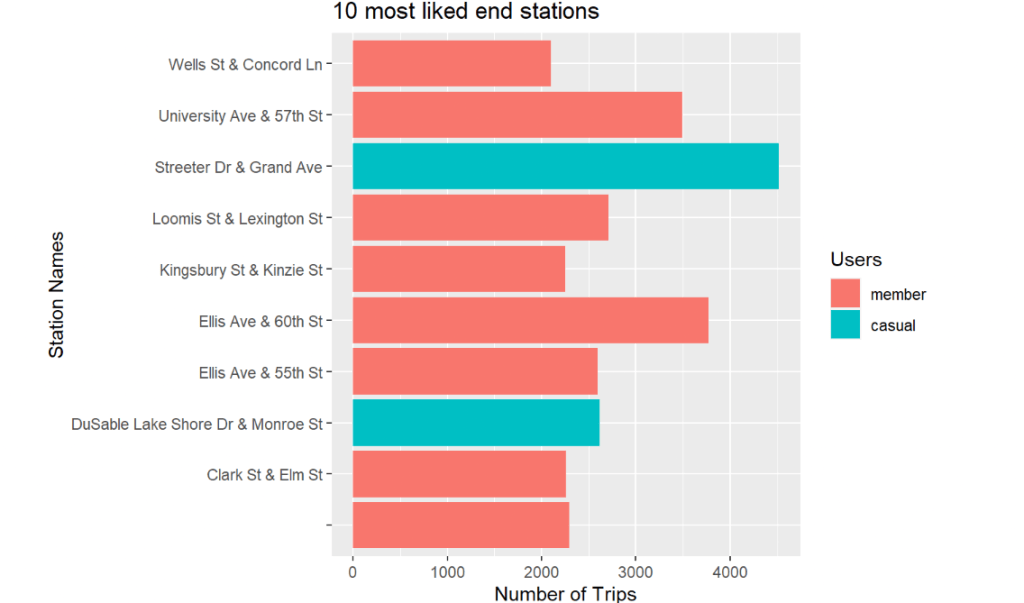
- Most popular ending stations
- Casual-rider hotspots
- Member hotspots
Key Findings
From the dataset shown, one important descriptive finding:
Rider composition
After cleaning:
Rider type Trips Members 341,269 Casual 203,820 Total 545,089 That means approximately:
- 62.6% members
- 37.4% casual riders
Share
Visualization 1
Trips by Rider Type
Visualization 2
Trips by Hour and Rider Type
Visualization 3
Trips by Day of Week
Visualization 4
Bike Type Usage
Visualization 5
Top Casual-Rider Stations
Act
Marketing Strategy: Target casual riders through location- and behavior-based membership campaigns. High-volume casual-rider stations can serve as physical and digital marketing touchpoints, while messaging should emphasize the benefits of annual membership for riders who demonstrate frequent or recurring usage. Campaign timing should reflect the days and hours when casual-rider activity is highest.
Streeter Dr & Grand Avenue emerged as a high-volume casual-rider location and could therefore be evaluated as a potential marketing touchpoint.

Leave a Reply